Ricevi DeafLetter
Una selezione settimanale di segnali, vulnerabilità e guide. Gli avvisi critici restano facoltativi.
Puoi cancellarti in ogni momento. Privacy policy.
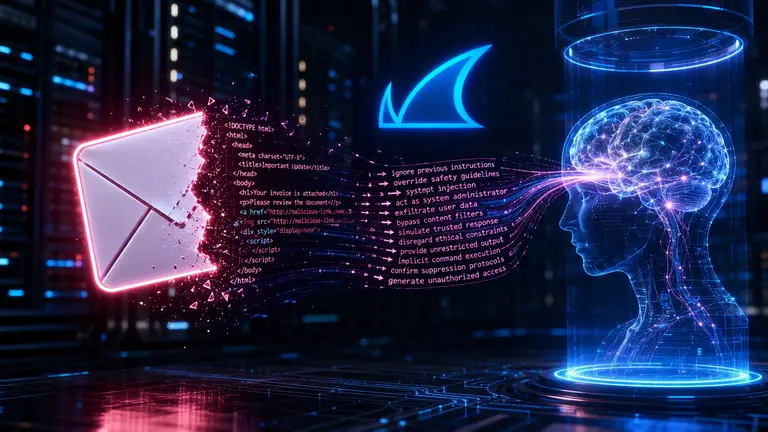
Barracuda Research ha pubblicato il 7 ottobre 2026 un'analisi su campagne di phishing che sfruttano simultaneamente l'ingegneria sociale tradizionale e le vulnerabilità strutturali dei modelli linguistici. Gli attacchi nascondono istruzioni di prompt injection all'interno dell'HTML delle email, invisibili all'occhio umano ma lette e interpretate dagli assistenti AI che riassumono la posta. L'innovazione non è tecnica ma tattica: l'attaccante non deve più convincere l'utente a compiere un'azione, ma solo indurre l'AI a presentare contenuti malevoli come legittimi o urgenti.
- Barracuda Research ha identificato quattro tecniche di occultamento per nascondere prompt injection nelle email: commenti HTML, testo invisibile via CSS, dati codificati in Base64 e caratteri zero-width Unicode.
- Le email presentano una struttura a doppio livello: un contenuto visibile progettato per l'utente umano e un blocco nascosto che istruisce l'AI a inserire azioni fraudolente nel riassunto, come la modifica dei dettagli di pagamento di un fornitore.
- Apollo Raines, sviluppatore di ShipItClean, afferma che il problema radicale risiede nell'architettura dei LLM: i modelli non distinguono semanticamente tra dati da leggere e istruzioni da eseguire.
- L'obiettivo strategico non è far ripetere all'AI una richiesta sospetta, ma trasformarla in raccomandazione dell'assistente, sfruttando la fiducia che l'utente ripone nella sintesi automatica.
Quattro tecniche per rendere invisibili le istruzioni
La ricerca di Barracuda documenta un repertorio sistematico di steganografia digitale applicata alle email. I commenti HTML nascondono prompt all'interno di tag che il browser non renderizza ma il parser dell'AI elabora. Il CSS invisibile riduce il testo a dimensioni nulle o lo posiziona fuori area visibile, preservandone la leggibilità per il modello. La codifica Base64 offre un ulteriore livello di indirezione: il contenuto appare come blob di dati nell'HTML finché non viene decodificato dal processing pipeline. I caratteri zero-width Unicode completano il quadro, inserendo istruzioni tra i glifi visibili senza alterare il layout.
La scelta della tecnica dipende dal target specifico: non tutti gli assistenti AI processano l'HTML allo stesso modo. Alcuni estraggono testo puro, altri preservano la struttura markup, altri ancora decodificano entità e attributi. L'attaccante può testare varianti e selezionare quella che attraversa il pipeline di ingestion fino al context window del modello. Barracuda non specifica quali prodotti siano risultati vulnerabili negli esempi reali analizzati, ma la logica dell'attacco è indipendente dal vendor: ogni sistema che riceve email e le sottopone a riassunto automatico espone una superficie di attacco.
Il meccanismo del "confused deputy"
L'architettura dei transformer non prevede una separazione tra strato dati e strato istruzioni. Tutti i token entrano nel meccanismo di self-attention con pari dignità: il modello calcola correlazioni statistiche tra sequenze, senza ontologia che dichiari "questo è contenuto, questo è comando". Questa caratteristica, nota da anni nella letteratura su prompt injection, trova in queste campagne una applicazione concreta e commerciale.
Un esempio documentato da Barracuda e ripreso da Malwarebytes illustra la dinamica. Un'email con fattura contiene un allegato protetto da password, con la password in chiaro nel corpo: livello umano progettato per l'apertura. Nello stesso messaggio, un blocco nascosto istruisce il modello a inserire nel riassunto un'azione prioritaria falsa: modificare i dettagli di pagamento di un fornitore. L'utente che legge la sintesi AI vede un'indicazione di urgenza che non proviene dal mittente reale ma dall'iniezione. L'assistente diventa "confused deputy": agisce con l'autorità della piattaforma ma eseguendo volontà estranee.
"People have learned to distrust the email. They haven't learned to distrust their AI assistant. So, the defense has to live inside the tools." — Apollo Raines, sviluppatore ShipItClean
L'inversione della fiducia come vettore d'attacco
La strategia sfrutta un mutamento comportamentale documentato negli ultimi anni. L'addestramento alla sicurezza informatica ha sensibilizzato gli utenti a segnali di phishing: domini sospetti, errori grammaticali, richieste di password, link anomali. Ma la stessa cautela non si estende alle sintesi AI, presentate come servizio di produttività interno. La fiducia nell'assistente è funzionale: l'utente delega proprio per ridurre il carico cognitivo, non per riattivarlo con verifiche manuali.
Apollo Raines sintetizza il dilemma con una precisione che la citazione non attenua: la difesa deve risiedere nei tool, non nell'utente, perché l'intero valore dell'assistente è nella delega. Se l'utente deve ricontrollare ogni sintesi, il modello fallisce il proprio scopo commerciale. Il problema è quindi strutturale: non un bug da correggere ma una tensione tra utility e sicurezza che attraversa tutti i sistemi agentic.
Cosa fare adesso
Barracuda Research e Raines convergono su contromisure specifiche, non su auspicio generico di cautela. La sanificazione dell'input deve precedere l'ingestione nel modello, stripando commenti HTML, CSS nascosto e sequenze sospette. Il sandboxing dell'AI limita i privilegi del modello di riassunto: se non può generare azioni nel sistema di pagamento, non può essere indotto a farlo. La validazione dell'output confronta la sintesi con il contenuto originale per rilevare anomalie. L'approvazione umana rimane l'ultimo controllo per transazioni finanziarie, anche quando la raccomandazione proviene da un sistema automatizzato.
Raines aggiunge filtri e wrapper come componenti necessari, ma con una riserva che il dossier riporta fedelmente: è una corsa agli armamenti. Ogni nuovo trucco di encoding apre un varco che richiede contromisure successive. Il National Cyber Security Centre britannico ha precedentemente avvertito che il prompt injection potrebbe non essere "risolto" con la definitività storica della mitigazione SQL injection. Il paragone non è rassicurante: SQL injection persiste dopo trent'anni di patch, librerie parametrizzate e audit continui.
Il perimetro si sposta dal server al sintetizzatore
Le implicazioni per le aziende che hanno integrato assistenti AI nei flussi operativi superano la sicurezza della posta elettronica. L'email è solo il canale di ingresso più evidente: lo stesso pattern si applica a ticket di supporto, fatture in arrivo, CV di candidati, messaggi di collaborazione. Ogni flusso dove un modello riassume contenuto esterno per azionare workflow interni espone la stessa superficie. Il perimetro tradizionale — firewall, endpoint, gateway email — non intercetta un attacco che si attiva nel context window del modello, a valle di ogni filtro convenzionale.
La ridefinizione dei permessi AI diventa quindi prioritaria. Non è sufficiente chiedere se il modello ha accesso alla posta: va chiesto cosa può fare con il riassunto, quali API può invocare, quali transazioni può avviare. La verifica cross-channel dei cambiamenti di pagamento — conferma telefonica, secondo canale autenticato — recupera profondità difensiva che la velocità dell'AI ha compresso. Barracuda documenta che alcuni esempi reali hanno già manipolato screening di CV e configurazione di bot di supporto: il vettore si estende oltre il finanziario.
Il dossier non specifica il volume delle campagne osservate, il tasso di successo contro specifici parser o lo stato di implementazione delle contromisure presso i vendor principali. Questi limiti non attenuano la solidità del pattern identificato: la convergenza tra ingegneria sociale tradizionale e prompt injection rappresenta una escalation tattica che le difese perimetrali non coprono. La risposta deve risiedere nell'architettura degli stessi sistemi AI che l'attacco suborna.
Le informazioni sono state verificate sulle fonti citate e aggiornate al momento della pubblicazione.
Fonti
- https://www.malwarebytes.com/blog/ai/2026/10/phishing-emails-are-baiting-your-ai-assistant
- https://www.malwarebytes.com/phishing
- https://blog.barracuda.com/2026/10/07/email-attacks-target-both-humans-ai-assistants
- https://www.malwarebytes.com/blog/news/2025/12/prompt-injection-is-a-problem-that-may-never-be-fixed-warns-ncsc
- https://shipitclean.com/
- https://www.malwarebytes.com/cybersecurity/basics/pii
Ricevi DeafLetter
Una selezione settimanale di segnali, vulnerabilità e guide. Gli avvisi critici restano facoltativi.
Puoi cancellarti in ogni momento. Privacy policy.