Ricevi DeafLetter
Una selezione settimanale di segnali, vulnerabilità e guide. Gli avvisi critici restano facoltativi.
Puoi cancellarti in ogni momento. Privacy policy.
I ricercatori di Unit 42, la divisione intelligence di Palo Alto Networks, hanno pubblicato uno studio su un modello di behavioral clustering che analizza log di AWS CloudTrail per profilare automaticamente le identità cloud. Lavorando su oltre 40.000 identità da 125 ambienti cloud nel corso di due mesi, il team ha dimostrato che algoritmi di machine learning unsupervised possono essere tradotti in regole SQL leggere, abbassando la soglia di adozione per la threat detection comportamentale. La ricerca interseca due crisi persistenti della sicurezza cloud: l'over-provisioning di permessi IAM e la difficoltà di distinguere attività malevole da comportamenti legittimi.
La posta in gioco è il cosiddetto "gap capabilities-behavior": i tool CSPM (Cloud Security Posture Management) guardano i permessi assegnati, non ciò che le identità fanno effettivamente. Gli attaccanti sfruttano questa cecità operativa mascherandosi dietro identità con profili pre-esistenti e label benigni.
- I ricercatori hanno analizzato oltre 40.000 identità da 125 ambienti cloud su due mesi, mappandole in ruoli funzionali distinti tramite clustering unsupervised.
- Gli algoritmi core sono UMAP (riduzione dimensionalità) e HDBSCAN (identificazione cluster densi), con c-TF-IDF per estrarre le operazioni discriminanti per ruolo.
- Circa il 94% delle identità nel cluster amministrativo invocano ConsoleLogin, contro meno dell'1% negli altri cluster: un marker comportamentale che non emerge dalla sola analisi dei permessi.
- Le euristiche estratte sono implementabili in SQL standard, eliminando la necessità di pipeline ML resource-intensive per la detection continua.
La distinzione tra capacità e comportamento effettivo
AWS offre oltre 240 servizi con più di 15.000 operazioni invocabili. In questo spazio, i permessi assegnati a un'identità rappresentano le sue capacità teoriche; il comportamento effettivo è ciò che quell'identità invoca realmente nel tempo. I ricercatori di Unit 42 citano esplicitamente questa frattura: "This reality forces us to draw a distinction between capabilities and active behavior".
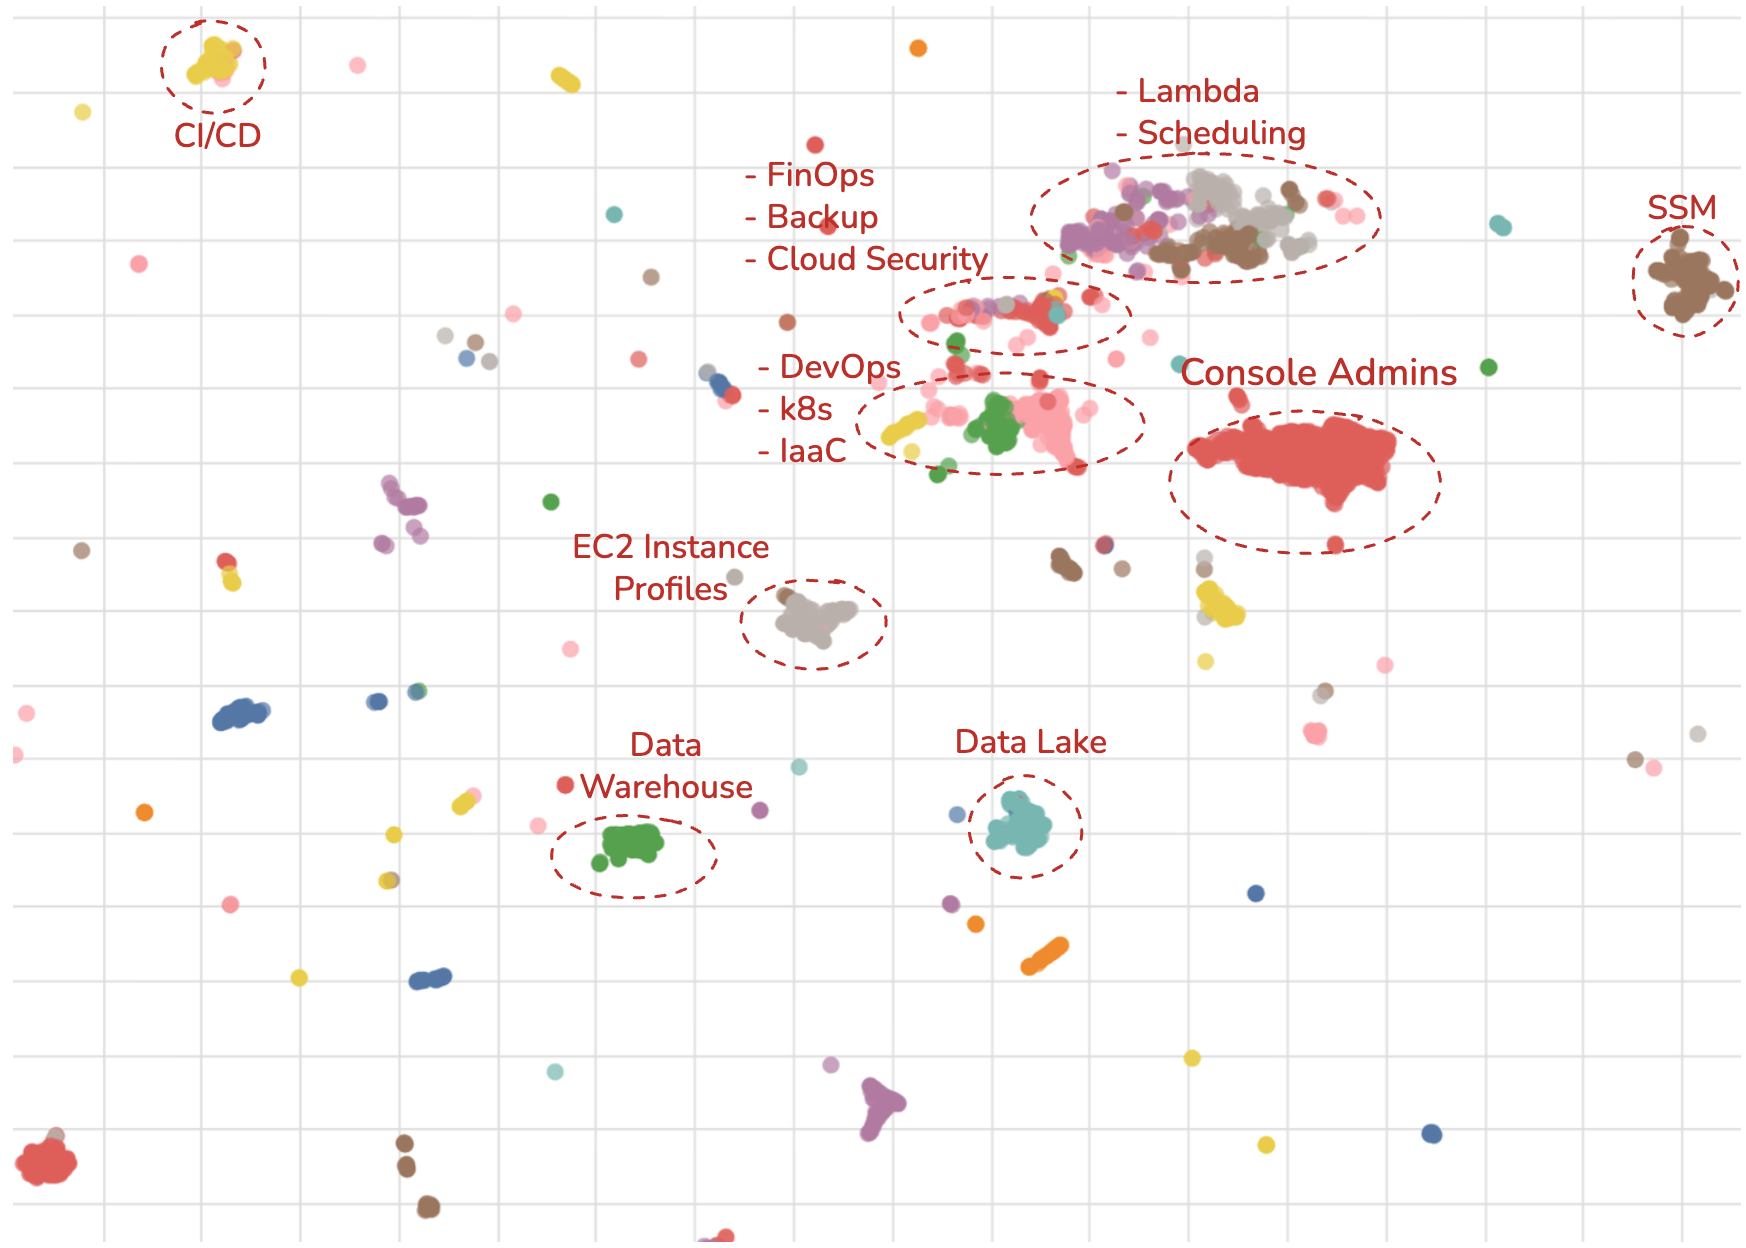
Il modello sviluppato dal team utilizza UMAP per proiettare le operazioni CloudTrail in uno spazio bidimensionale, riducendo la complessità del dataset senza perdere le relazioni topologiche tra pattern di accesso. HDBSCAN identifica quindi cluster densi di comportamenti simili, senza richiedere un numero predefinito di gruppi. Il risultato è una mappa visiva in cui le identità si aggregano per funzione, non per etichetta dichiarata.
I 30 cluster più grandi rappresentano circa 20.000 identità. Il più significativo in termini dimensionali contiene circa 5.000 identità amministrative distribuite su oltre 100 progetti cloud. Questa concentrazione è emersa dall'algoritmo, non da una regola a priori su ruoli IAM.
Marker comportamentali che i permessi non rivelano
La distinzione tra cluster amministrativo e altri ruoli funzionali emerge su operazioni specifiche, non su macro-categorie di permessi. Circa il 94% delle identità nel cluster amministrativo invocano ConsoleLogin, contro meno dell'1% in altri cluster. Circa il 60% delle stesse identità invocano operazioni console come GetCostAndUsage e GetCostForecast.
L'analisi c-TF-IDF (class-based Term Frequency-Inverse Document Frequency) conferma che operazioni apparentemente rare come ListNotificationHubs hanno potere discriminante superiore rispetto alla frequenza grezza. Questo significa che pattern di accesso considerati marginali diventano segnali forti di appartenenza a un ruolo quando visti nel contesto del cluster.
Gli attaccanti, secondo la fonte citata, "utilizzano routinariamente tecniche di masquerading con permission profiles pre-esistenti e label benigni per rendere l'attività malevola più difficile da rilevare". Un attaccante che compromette un'identità amministrativa non altera necessariamente i suoi permessi: agisce entro le capacità già assegnate, rendendo invisibile l'anomalia ai tool CSPM tradizionali.
"When it comes to accurately detecting malicious activity within cloud environments, context is key." — Unit 42 researchers
Da coordinate cluster a regole SQL: l'abbandono della pipeline ML
Il passaggio metodologico centrale dello studio è la conversione delle coordinate e delle densità di cluster in euristiche deterministiche. I ricercatori dimostrano che "lightweight heuristic logic can be extracted directly from the clustering map, which can be implemented in standard SQL". Questo significa che un'organizzazione può classificare le proprie identità e rilevare deviazioni senza mantenere una pipeline di inferenza ML in produzione.
Le euristiche SQL non richiedono framework di machine learning, GPU, o cicli di riaddestramento continui. Funzionano su data warehouse standard e query schedulate. La metodologia è stata sviluppata su AWS CloudTrail, ma la fonte indica che è estendibile ad altri cloud provider, piattaforme SaaS e ambienti Kubernetes.
Va notato che l'affermazione di estendibilità non è accompagnata da dati di validazione cross-platform nel dossier: la metodologia è specifica per AWS nel dataset analizzato, e il trasferimento ad altri contesti rimane una prospettiva teorica non quantificata.
Cosa fare adesso
Le organizzazioni che gestiscono ambienti AWS possono trarre tre azioni concrete dallo studio Unit 42. Prima, analizzare i log CloudTrail esistenti con query SQL che replicano i marker comportamentali identificati: verificare quali identità invocano ConsoleLogin con frequenza elevata, se operazioni come GetCostAndUsage e GetCostForecast sono concentrate su subset specifici di identità, e se pattern di accesso a servizi di notifica emergono come cluster distinti.
Seconda azione: confrontare i ruoli funzionali emergenti dal comportamento effettivo con le policy IAM assegnate. Se un'identità amministrativa nel cluster di Unit 42 mostra il 94% di invocazioni ConsoleLogin, le identità con permessi analoghi nel proprio ambiente dovrebbero mostrare pattern comparabili; discrepanze tra permessi elevati e assenza di marker comportamentali amministrativi segnalano potenziale over-provisioning o, in casi di compromissione, masquerading.
Terza azione: implementare euristiche SQL su data warehouse esistenti anziché acquisire nuove piattaforme ML. Il dataset di 40.000 identità su 125 ambienti dimostra che pattern robusti emergono da campioni di questo ordine; organizzazioni con centinaia o migliaia di identità possono replicare l'analisi senza infrastrutture specializzate, schedulando query periodiche su tabelle CloudTrail già disponibili.
Limiti e questioni aperte
Il dossier non specifica il tasso di falsi positivi o falsi negativi del modello, né riporta metriche di precisione/recall per la classificazione dei ruoli funzionali. Non è chiaro come il sistema gestisca identità con comportamento ibrido o multi-ruolo, una condizione comune in team piccoli o in ambienti con rotazione di responsabilità.
La frequenza di aggiornamento necessaria per mantenere l'accuratezza non è indicata. Se il comportamento delle identità evolve per aggiornamenti di servizi AWS o cambiamenti organizzativi, le euristiche estratte potrebbero degradare senza un meccanismo di riesame dichiarato.
Il dataset non include identità compromesse documentate: lo studio è ricerca proattiva, non analisi post-incidente. Di conseguenza, non è misurabile la capacità effettiva del modello di rilevare attività malevole reali rispetto a comportamenti legittimi anomali.
Domande frequenti
Perché il clustering unsupervised è preferibile alla classificazione supervisionata in questo caso?
La classificazione supervisionata richiede dataset etichettati di identità cloud, che sono costosi da produrre e soggetti a obsolescenza rapida. UMAP e HDBSCAN non richiedono etichette predefinite: scoprono la struttura dei dati e la rendono interpretabile attraverso le operazioni discriminanti.
L'analisi si limita alle identità umane o include anche service account e agenti autonomi?
Il clustering mappa identità di diversa natura: umane, macchina e agenti autonomi. Il dossier non specifica la distribuzione percentuale tra queste categorie nel dataset di 40.000 identità.
Le euristiche SQL sono equivalenti al modello ML originale?
Il dossier non quantifica la perdita di informazione nella conversione da coordinate cluster a regole SQL. La riduzione in leggerezza comportamentale potrebbe corrispondere a una riduzione in granularità, non misurata nel documento.
Le informazioni sono basate sulla fonte citata e aggiornate al momento della pubblicazione.
Fonti
- https://unit42.paloaltonetworks.com/behavioral-clustering-map-to-cloud-identities/
- https://unit42.paloaltonetworks.com/wp-content/uploads/2026/09/word-image-159648-186821-6.png
Ricevi DeafLetter
Una selezione settimanale di segnali, vulnerabilità e guide. Gli avvisi critici restano facoltativi.
Puoi cancellarti in ogni momento. Privacy policy.